自回归扩散模型能否用于生成市场数据
Can you use autoregressive diffusion to generate market data?
Jane Street 实习生 Kavish 尝试用自回归扩散模型生成美股订单簿事件,对比发现 DDPM 在高噪声预测下会发散,flow matching 在采样稳定性上表现更好。
针对扩散模型在订单簿事件这类连续与离散混合数据上的落地尝试记录较完整,给出了 DDPM 与 flow matching 的实测差异以及对尖峰分布的处理思路。
以下是 2026 年夏季实习生项目系列文章的一部分——更多内容,请参阅"实习生成果展示,2026 特别加长版"
在量化金融领域,我们常用的模型是针对给定标的(例如将挂单加入订单簿、撤销这些订单、执行等)获取市场数据事件流,并预测该标的的未来价格。生成式模型则较为少见。试想一种模型,它不仅能给出标的价格的点估计,还能真正合成订单簿事件——包括它们到达交易所的时间。你当然会得到价格预测,但你的推演将比单纯的预测丰富得多。
但市场数据究竟是什么类型的数据?生成式模型需要回答这个问题。它更像视频,还是文本?也就是说,它是连续的还是离散的?市场数据似乎兼具两者的特征。订单簿随着市场参与者挂上或撤下挂单而一步步演变;这无疑是一个离散的动作空间。然而,许多订单最重要的参数(比如价格)具有如此高的基数,以至于它们看起来基本上是连续的。有些参数本身就是连续的:时间就是一个容易忽视但对生成式模型至关重要的参数,例如"新订单何时到达交易所"。即便如此,这也过于简化了实际情况。在实际中,分布是尖峰状的:"pennying"(即将价格改进一个 tick)比改进两个tick 要常见得多,而订单往往成批出现,例如在整数时间点附近。
探索这些复杂性的一种方式是假设你的数据是连续的,然后看看这种做法在何处会失败。今年夏天,一位研究实习生 Kavish 构建了一个用于市场数据的扩散模型。扩散模型和流匹配模型是处理序列、多模态数据的强大工具,应用于图像、视频、机器人和音频等领域。Kavish 从《Autoregressive Image Generation without Vector Quantization》中获得灵感,利用自回归扩散创建了一个事件级的市场数据生成模型。
在研究过程中也有一些技术发现——例如,Kavish 发现 DDPM 虽然在理论上非常适合扩散模型中的去噪,但会出现发散,而流匹配的表现则要好得多。但最重要的结论是,完全连续的扩散模型并不适合真实市场数据的锯齿状特征。Kavish 一方面通过平滑处理点质量,另一方面对模型的部分目标进行离散化,这些尝试大大厘清了最终的市场数据生成模型可能呈现的样貌。
建模与设置
Kavish 研究了四年的美股数据,每行数据包含时间戳、价格、类型(成交、订单、撤单等)以及其他信息。扩散模型会尝试为下一个事件生成这些特征,然后以自回归方式附加到数据流中。
沿用上文引用的 Li 等人的论文,他采用了编码器–扩散器(encoder–diffuser)架构,具体而言是一个带因果掩码(causally masked)的 Transformer 编码器,在每个位置生成潜在嵌入。训练期间,每个位置的潜在表示被送入一个小型事件类型(event-kind)头,输出一个二分类概率分布,用于指示下一个事件是成交(trade)还是最优买卖报价("best bid and offer",BBO)更新。而价格、经过的时间等连续目标,则由扩散头生成,该扩散头以对应的潜在表示和真实的事件类型为条件,通过标准的 AdaLN 条件机制实现。
推理时,只需将最后一个事件的编码潜在表示送入事件类型头,并从输出分布中采样一个事件。下一个事件的连续特征由扩散头生成,以最后一个事件的潜在表示以及采样得到的事件为条件。
DDPM 与流匹配(Flow Matching)
DDPM,即"denoising diffusion probabilistic model"(去噪扩散概率模型),会预测施加在样本上的噪声,并通过减去按比例缩放后的噪声预测、再除以剩余的信号强度来得到对干净样本的估计。DDPM 在图像生成等领域取得了巨大成功,但在高噪声水平下,噪声预测中哪怕很小的误差也会在干净目标估计中造成很大的偏差。而流匹配(Flow matching)则是在噪声和数据之间进行线性插值,并训练网络预测沿这条直线的速度(即数据减去噪声)。这样一来,采样得到的轨迹近乎直线,因此流模型只需相对较少的步数即可被精确积分。
本质上这是同一目标的两种不同参数化方式,但 Kavish 发现这些差异其实影响很大。他最初的扩散头在 1,000 步余弦调度上进行预测,正如 Improved DDPM 中所推荐的那样。在推理时,生成过程按照 DDIM 运行。不幸的是,这种配置并不稳定,导致去噪轨迹爆炸式发散,7 个连续目标上有 88–95% 的值偏离分布均值超过 8 个标准差。请注意图中最左侧的方框,轨迹(那些细长的粉色丝线,在背景上几乎难以察觉)迅速发散到边缘。
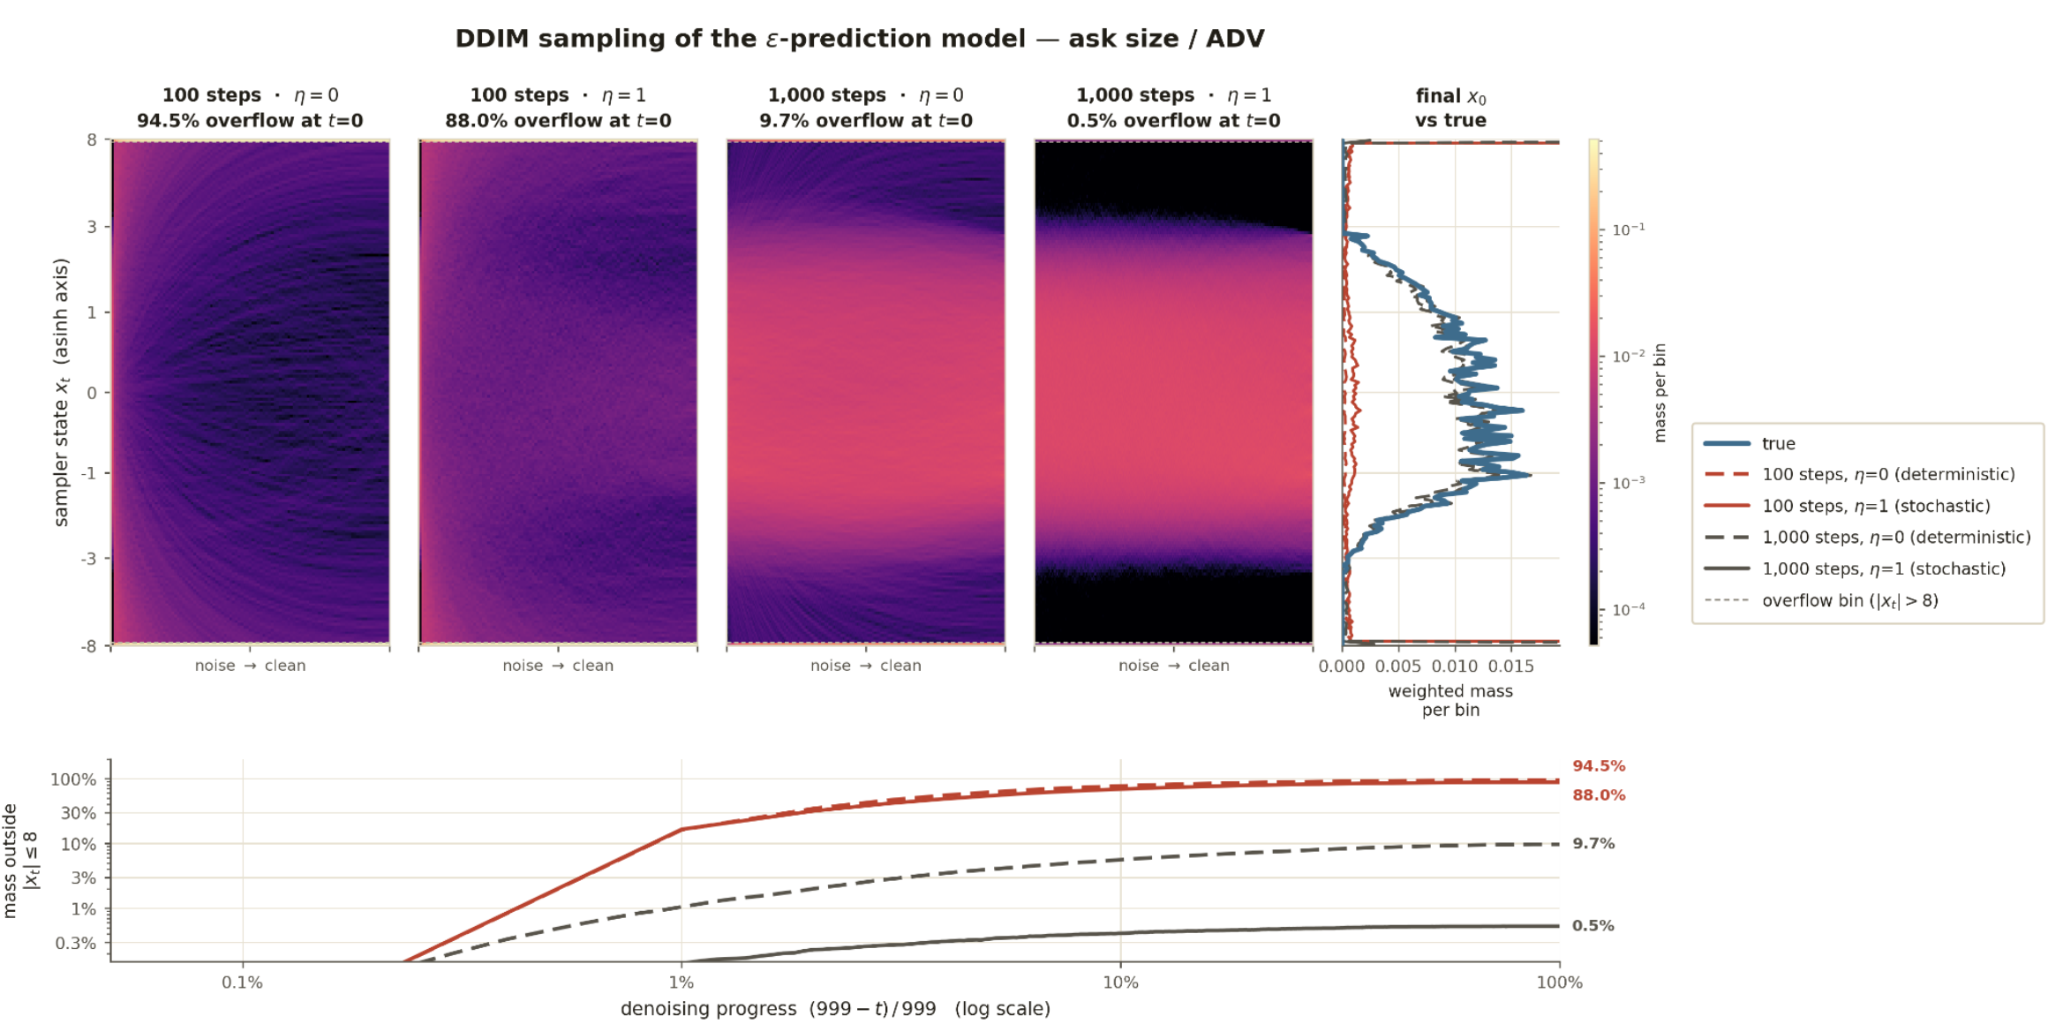
这是由计算时的缩放造成的。如图所示,使用更多采样步数可以减小每步的增量,从而防止溢出量过大。此外,向采样过程加入随机性()可以将去噪过程正则化为标准高斯分布,减少偏差。但是,虽然可以调整噪声调度来应对这种不稳定性,或者在推理时进行干预以防止去噪爆炸,Kavish 发现 rectified flows 方法开箱即用效果就很好。因此他切换到了流匹配模型。
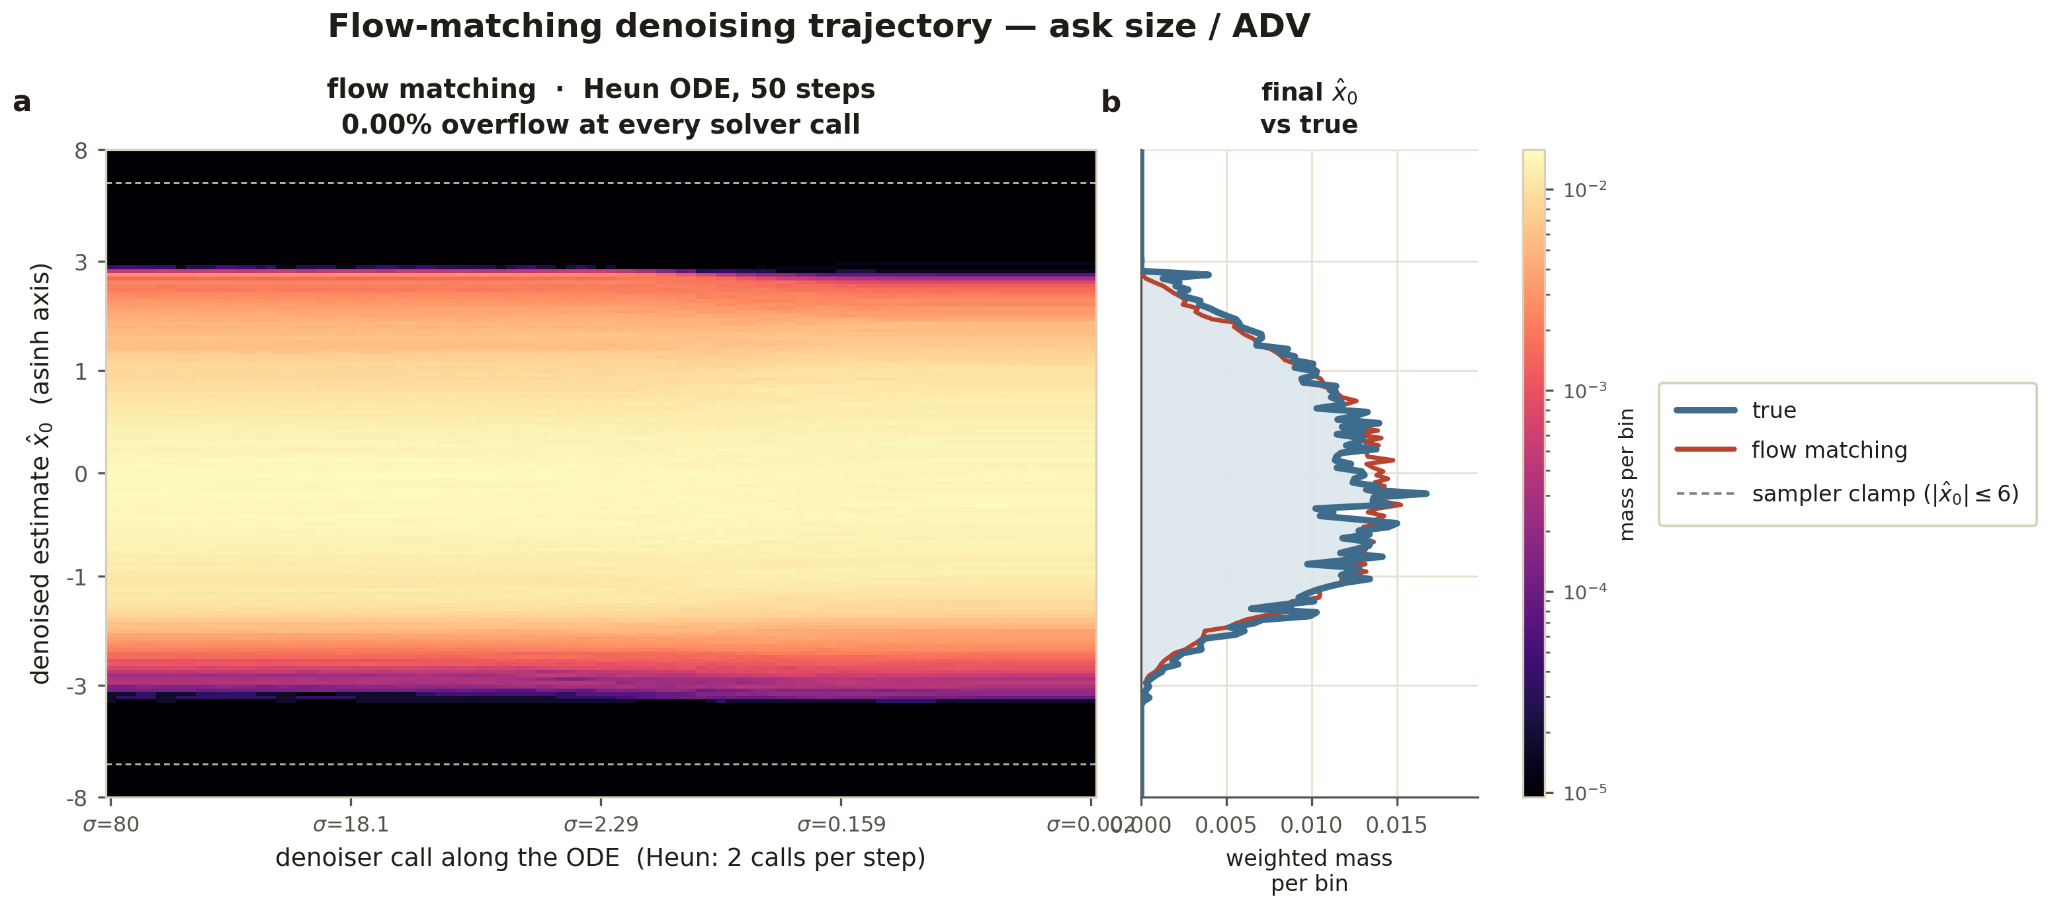
处理不连续性
项目的大部分时间都花在了应对一个根本性的问题上:市场数据既不是完全连续的,也不是完全离散的。例如视频——扩散模型非常适合处理视频——在快照上是连续的(每一帧都是一系列连续的像素强度和颜色),在演化上也是连续的(像素可以从一帧到下一帧取任意连续的值)。相比之下,市场数据的快照虽然是连续的,但其演化方式却非常离散,受市场微观结构支配。
当你观察特征分布时,这一点便一目了然——其特征是锐利的边界:
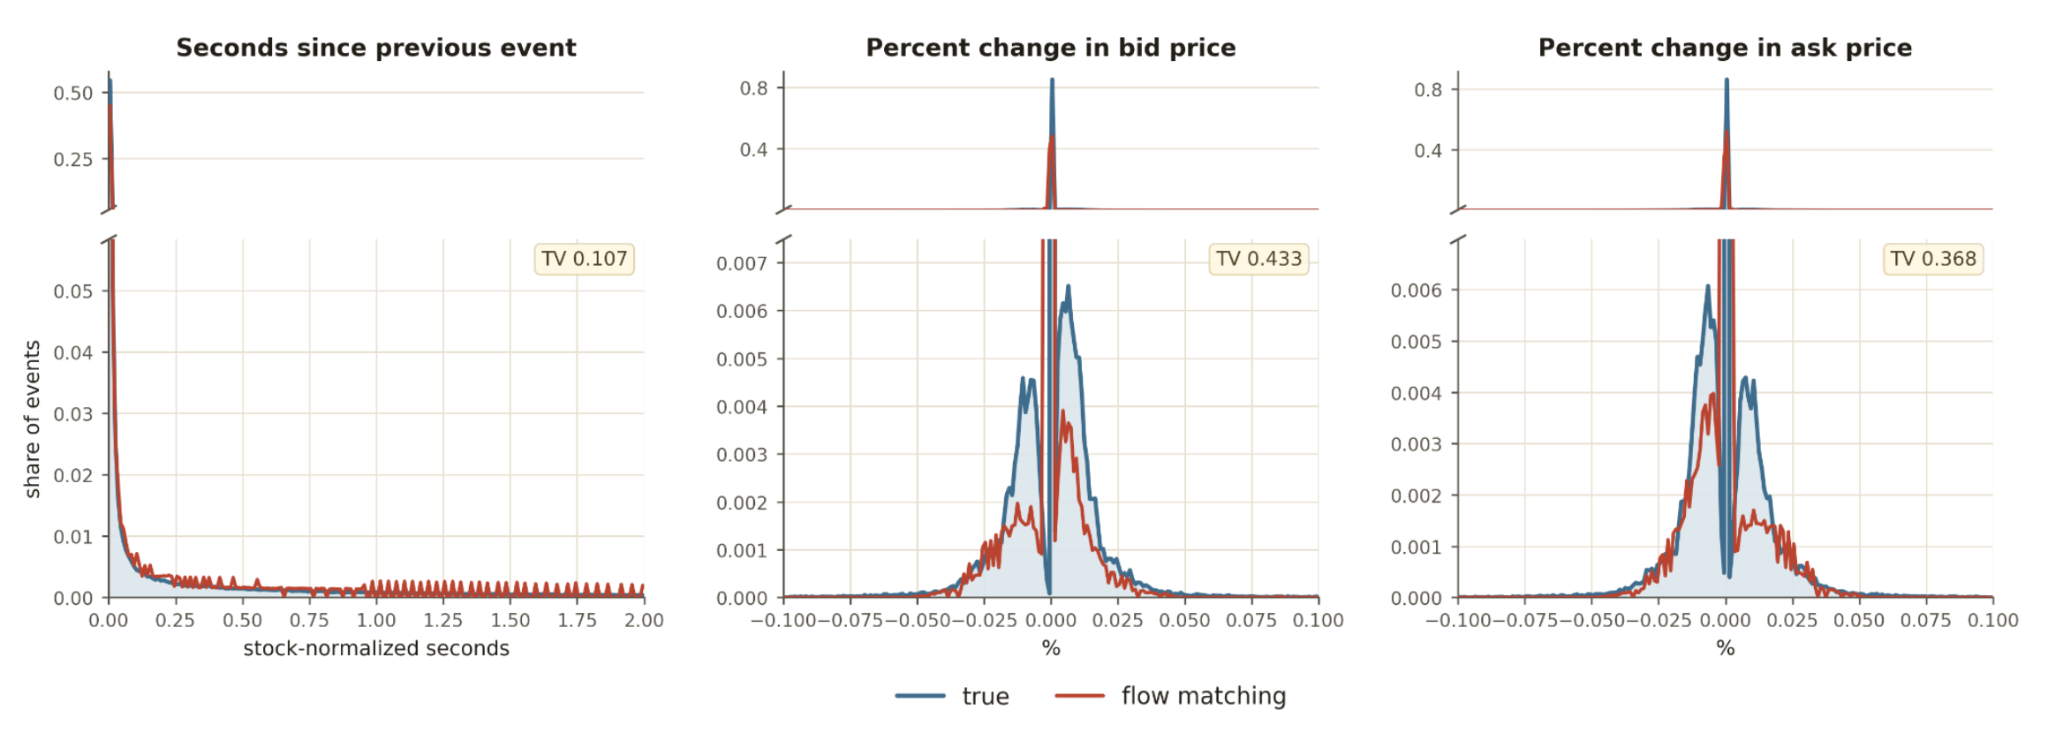
订单的时间并非正态分布,而是相当聚集成团,在零秒(同时到达的事件)、最早可能的反应时间以及整数秒附近存在点质量。价格则倾向于围绕买卖报价中点,或当前买价,或当前卖价聚拢,因此你也会在那里看到明显的间断点。
由于分类预测也存在类别失衡——只有 8% 的事件是成交,其余都是 BBO 变更;于是分类头会过度预测成交——Kavish 尝试将分类头预测的类别数量拆分。他把 BBO 变更拆成一组常见类别,例如"仅数量变化"(价格不变)、"卖价上升"、"买价下降"等等。这样做还有一个额外的好处:使他能够把某些特征中的"原子"(即锐利的间断点)单独建模,从而让"耗时为零"可以作为独立类别来预测。最终他得到了一个 20 类的分类头,以及更简洁的扩散目标,例如"非零时间间隔有多大"(因为零已由分类建模)和"买价变动幅度是多少"(因为方向已是一个类别)。
这种方法显著改善了事件类别目标和连续目标的边缘分布,但显然涉及大量手工工程。用分类头为每个特征的每个间断点单独建模,在更大的特征集合中就难以扩展了。例如,真实数据很可能包含更多的变量,包括像"这是在哪家交易所发生的?"这样高基数的类别,从而可能导致分类类别数量爆炸。
于是 Kavish 开始寻找另一种处理间断点的方法。
原子平滑
他采用了一种方法,最终被他命名为"原子平滑"(atom smoothing)。其思路是:取真实的、带尖峰的概率分布,先将其平滑掉,再将尖峰重新"雕刻"回去,以一种既能捕获那里概率质量、又不会造成间断点的方式。例如:
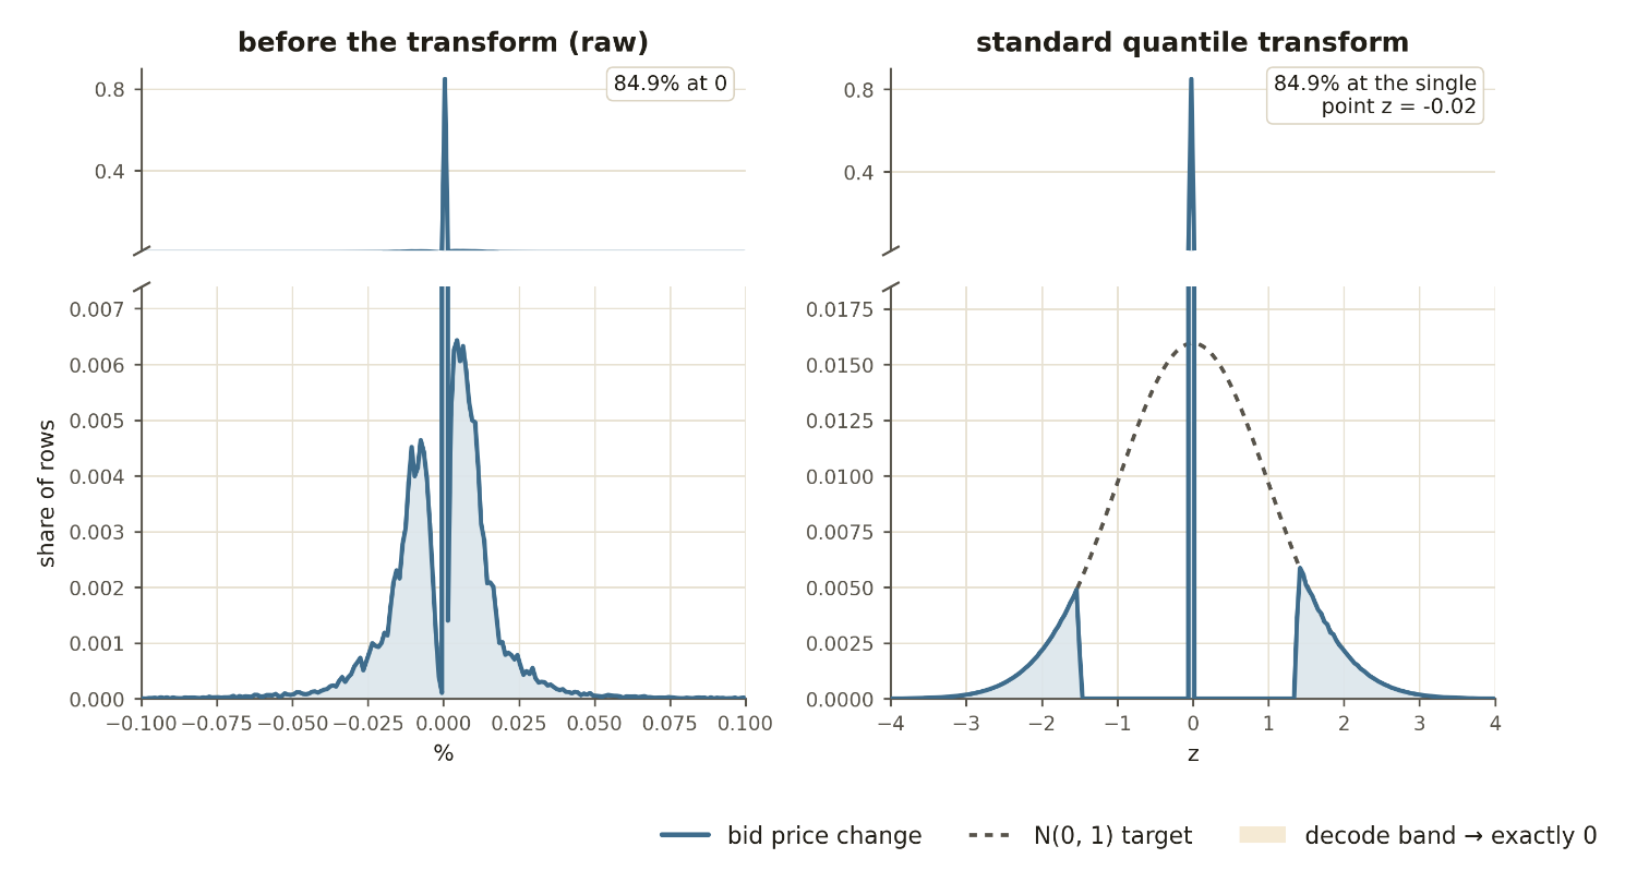
为了使这种方法效果良好,你必须选择合适的变量表示方式:在某种表示下尖锐的尖峰,在另一种表示下可能就不那么尖锐;你需要把任何尖锐的尖峰揭示出来并加以平滑。
结果与推广
Kavish 发现,使用 flow matching 和 atom smoothing 的扩散模型效果相当不错。他将模型在每个 target 上的输出边际分布与真实边际分布进行了比较。这是在单步(one-step)设定下完成的:他以包含 10,240 个事件的真实 context 为条件,从模型中抽取一个下一事件,并将其与实际发生的事件进行比较。他通过总变差(TV)散度来量化与真实 per-target 边际分布之间的偏差,计算方式为
与 这两个分布之间。
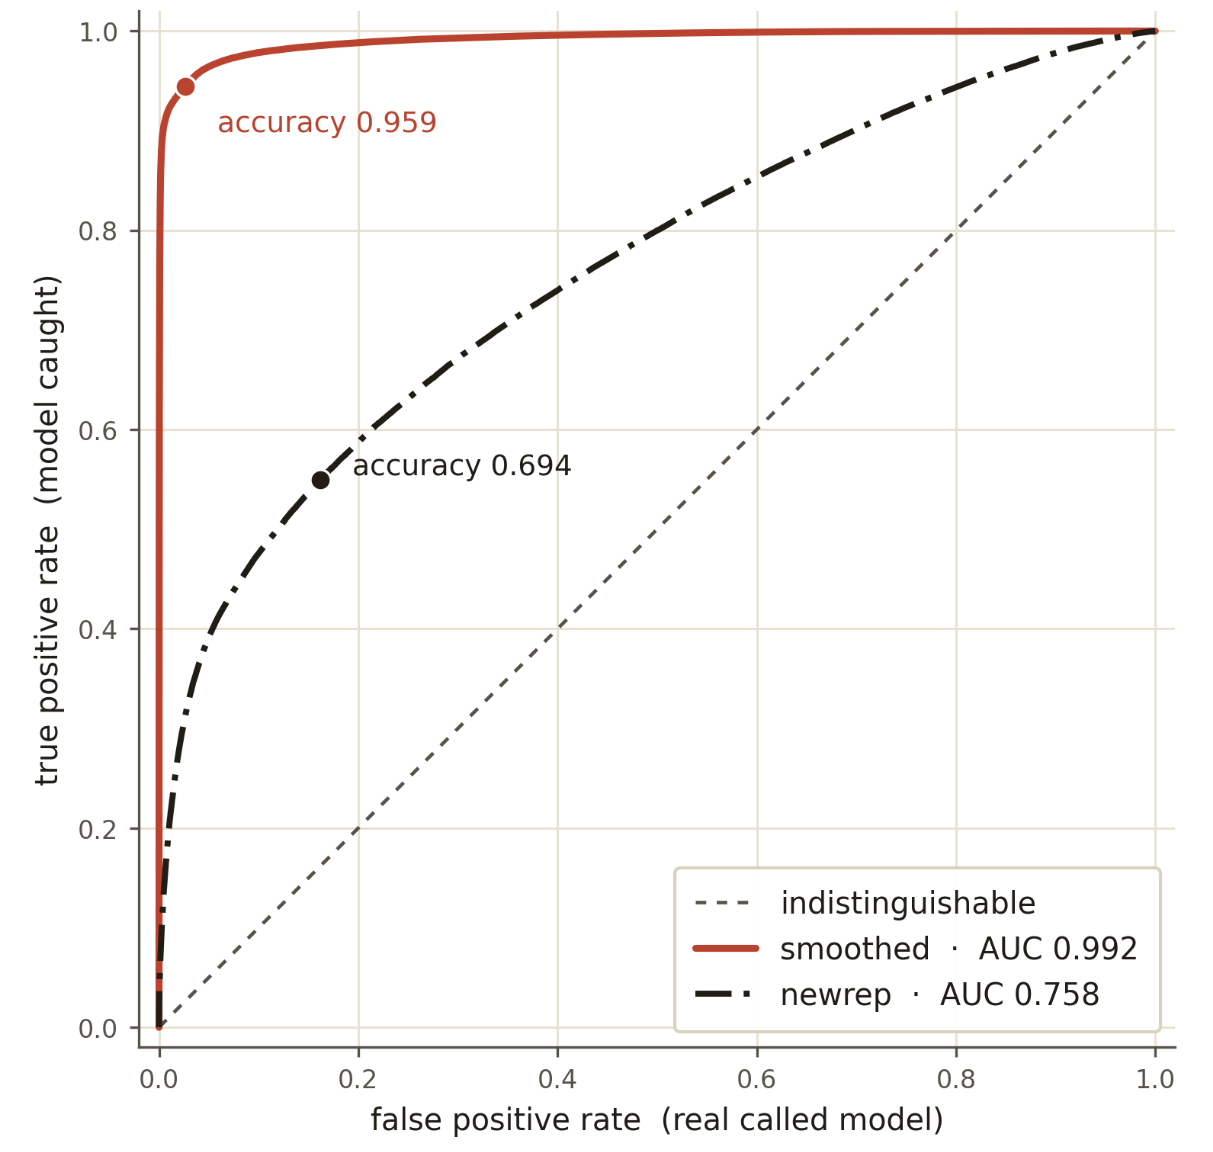
虽然边缘分布的对齐非常重要,但它并不能捕捉特征之间的联合关系,也无法捕捉与先前上下文的时间一致性。因此 Kavish 还训练了一个分类器来区分模型生成的预测与真实事件。该分类器读取一段由真实上下文事件构成的窗口,再接一个候选下一事件,然后预测该候选事件是来自模型还是来自数据。采用为原子平滑而优化的特征表示的生成器,所生成的样本要逼真得多:
当然,该模型的最终目标是生成自回归滚动预测:
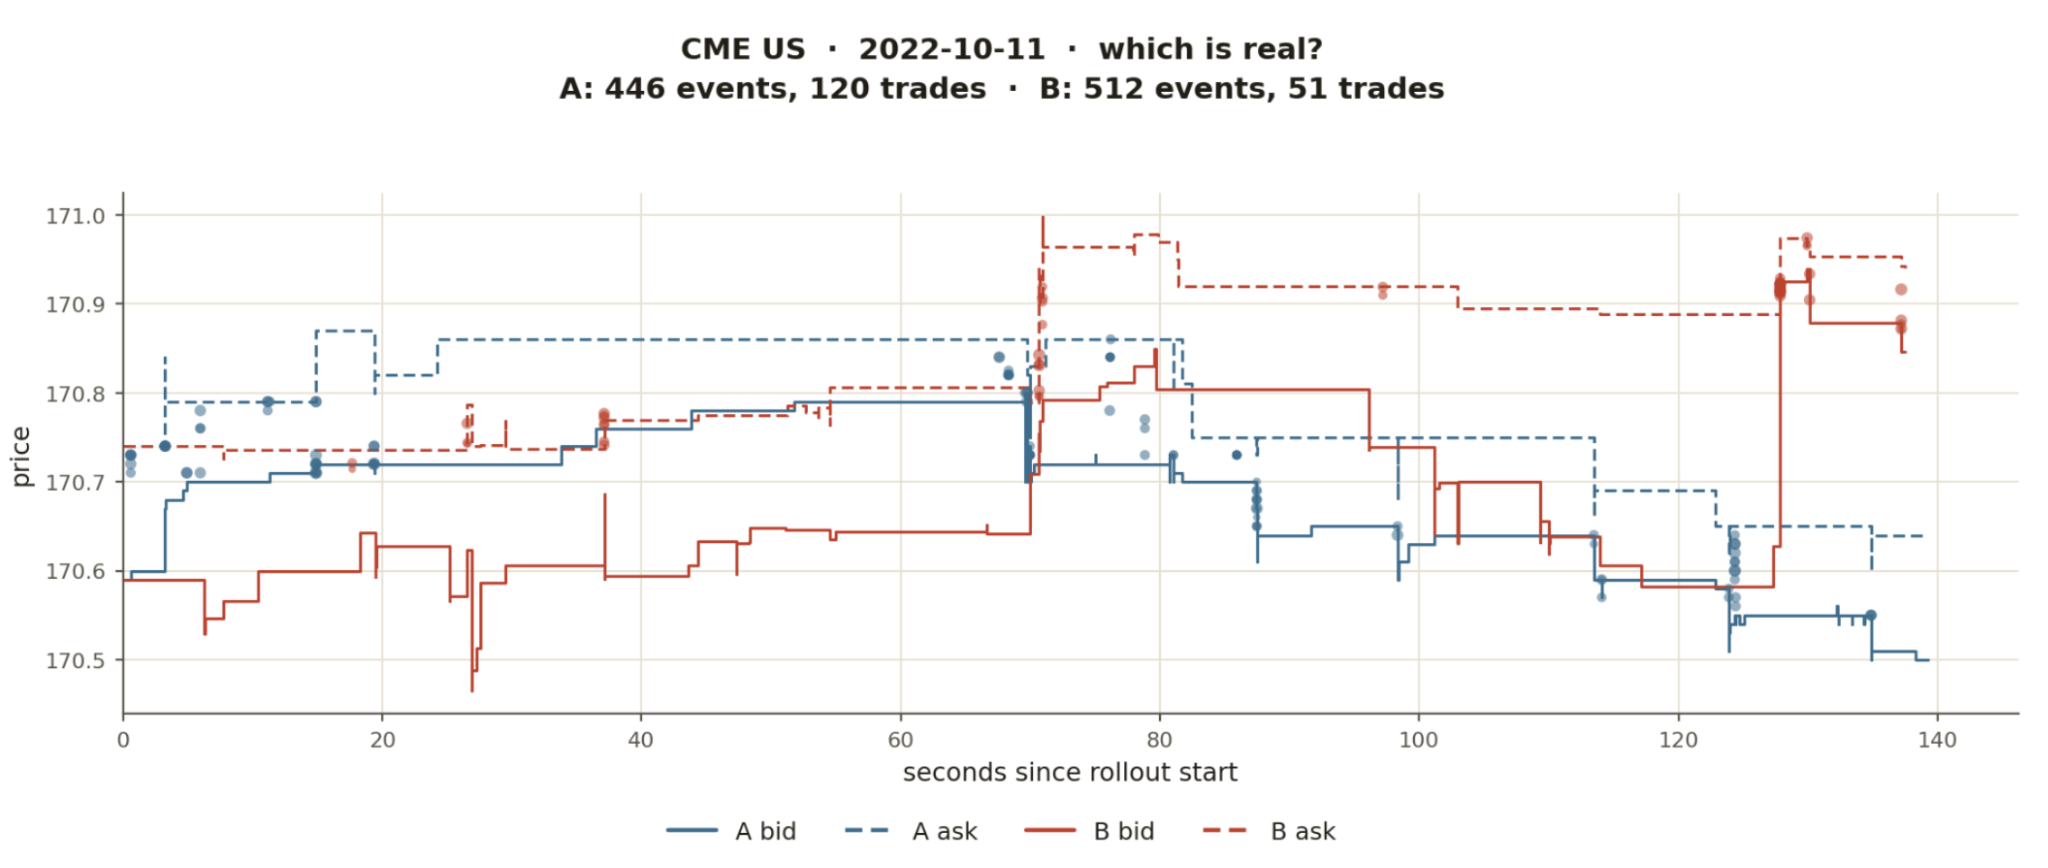
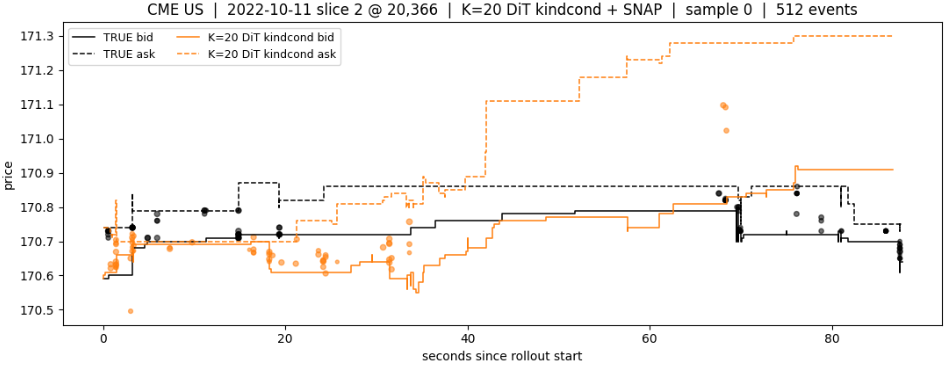
模型的预测自然会随着预测时间的拉长而逐渐退化,而一个值得进一步研究的问题是:退化程度有多大?在第二张图中你可以看到,在合成滚动预测中,CME US 的价差在扩大。
Kavish 的模型还不够精确,尚不能当作现实的生成器来用,但他在实习期间的研究厘清了哪些是关键旋钮:你应该在模型中融入多少离散性?(也就是说,哪些内容应当以分类方式预测,哪些应当用扩散模型来预测?)以及应当如何表示并平滑特征分布,让扩散模型发挥出最佳效果?
这个项目让我们认识到,行情簿事件同时存在于连续空间("卖盘规模增加 10%")与离散动作空间("将买价加价一档")之中。这只是看待同一件事的两种视角。如果你想生成行情数据,就必须正确地对这种融合进行建模。
期待明年夏天……
如果你有兴趣从事类似的工作,欢迎申请!你可以在此处了解更多详情:Jane Street 实习项目。我们 2027 年机器学习研究实习的申请通道现已开放!
来源:Hacker News · blog.janestreet.com